File robots.txt là gì? Cú pháp, mẫu chuẩn và cách kiểm tra
File robots.txt là tệp văn bản đặt ở thư mục gốc của website (ví dụ https://tenmien.com/robots.txt) để cho các trình thu thập dữ liệu như Googlebot biết được phép và không được phép thu thập những URL nào. Robots.txt dùng để kiểm soát việc thu thập, không phải công cụ để ẩn trang khỏi Google: muốn trang không xuất hiện trên kết quả tìm kiếm, hãy dùng noindex.
Bài viết giải thích các lệnh robots.txt Google hỗ trợ, cách viết quy tắc với ký tự đại diện, mẫu robots.txt cho WordPress và WooCommerce (lấy từ chính website Xuyên Việt Media), cách kiểm tra trong Search Console và những lỗi có thể khiến cả website biến mất khỏi Google.
Mục lục nội dung
File robots.txt là gì?
Robots.txt là tệp văn bản thuần, mã hóa UTF-8, tuân theo Giao thức loại trừ robot (Robots Exclusion Protocol). Khi đến một website, trình thu thập dữ liệu hợp lệ sẽ đọc tệp này trước để biết khu vực nào không nên truy cập.
- Vị trí: bắt buộc ở thư mục gốc của host. Tệp đặt ở thư mục con sẽ không có hiệu lực.
- Phạm vi: chỉ áp dụng cho đúng giao thức, tên miền và cổng của nó.
https://tenmien.com/robots.txtkhông áp dụng chohttps://blog.tenmien.com. - Không bắt buộc phải có: nếu không có robots.txt (trả mã 404), Google coi như được thu thập mọi URL.
Các lệnh robots.txt Google hỗ trợ
| Lệnh | Chức năng | Ví dụ |
|---|---|---|
User-agent | Chỉ định trình thu thập áp dụng nhóm quy tắc; * là mọi trình thu thập | User-agent: Googlebot |
Disallow | Không cho thu thập đường dẫn bắt đầu bằng giá trị này | Disallow: /wp-admin/ |
Allow | Cho phép thu thập một đường dẫn con trong vùng đã chặn | Allow: /wp-admin/admin-ajax.php |
Sitemap | Khai báo URL đầy đủ của sitemap | Sitemap: https://tenmien.com/sitemap_index.xml |
Google không hỗ trợ lệnh Crawl-delay và không còn hỗ trợ lệnh noindex trong robots.txt. Một số công cụ tìm kiếm khác có thể vẫn đọc Crawl-delay.
Ký tự đại diện và thứ tự ưu tiên
*đại diện cho chuỗi ký tự bất kỳ:Disallow: /*?s=chặn mọi URL có tham số tìm kiếm?s=.$đánh dấu kết thúc URL:Disallow: /*.pdf$chặn các URL kết thúc bằng .pdf.- Đường dẫn phân biệt chữ hoa, chữ thường.
- Khi
AllowvàDisallowcùng khớp một URL, Google áp dụng quy tắc cụ thể hơn (đường dẫn dài hơn); khi các quy tắc xung đột ngang nhau, Google chọn quy tắc ít hạn chế hơn.
Robots.txt khác noindex thế nào?
Đây là điểm hay nhầm nhất. Robots.txt chặn thu thập; noindex chặn lập chỉ mục.
| Mục tiêu | Công cụ phù hợp | Lưu ý |
|---|---|---|
| Giảm thu thập URL ít giá trị (tìm kiếm nội bộ, URL lọc, URL hành động) | Robots.txt | URL bị chặn vẫn có thể xuất hiện trên Google nếu có liên kết trỏ tới, chỉ là không có mô tả |
| Không cho trang xuất hiện trên Google | Noindex | Phải cho phép thu thập để Google đọc được thẻ noindex |
| Bảo vệ nội dung riêng tư | Mật khẩu, phân quyền | Robots.txt công khai, ai cũng đọc được |
| Trang đã xóa vĩnh viễn | Mã 404 hoặc 410 | Không cần chặn trong robots.txt |
Lỗi kinh điển: vừa gắn noindex vừa chặn trang đó trong robots.txt. Google không thu thập được nên không thấy noindex, trang có thể vẫn nằm trên kết quả tìm kiếm.
Mẫu robots.txt cho WordPress và WooCommerce
Đây là robots.txt đang chạy trên xuyenvietmedia.com, được chúng tôi chỉnh lại tháng 10/2026 sau khi audit:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

# Tim kiem noi bo
Disallow: /?s=
Disallow: /*?s=
Disallow: /*&s=

# URL hanh dong va loc/sap xep WooCommerce
Disallow: /*add-to-cart=
Disallow: /*?orderby=
Disallow: /*&orderby=
Disallow: /*?filter_
Disallow: /*&filter_
Disallow: /*?min_price=
Disallow: /*&min_price=
Disallow: /*?max_price=
Disallow: /*&max_price=

# Tra loi binh luan
Disallow: /*?replytocom=

Sitemap: https://xuyenvietmedia.com/sitemap_index.xml
Lý do của từng nhóm:
- Tìm kiếm nội bộ: trang kết quả tìm kiếm có thể sinh vô hạn URL, phần lớn trùng hoặc rỗng.
- URL hành động và lọc của WooCommerce: thêm vào giỏ, sắp xếp, lọc giá tạo nhiều biến thể URL của cùng một danh mục. Xem faceted navigation.
- replytocom: mỗi nút “trả lời bình luận” tạo một URL trùng nội dung bài.
Những thứ không chặn: thư mục /wp-content/ (chứa CSS, JavaScript, ảnh mà Google cần để hiển thị trang), trang giỏ hàng, thanh toán, tài khoản. Các trang này được xử lý bằng noindex và đưa ra khỏi sitemap, vì nếu chặn bằng robots.txt, Google sẽ không đọc được thẻ noindex.
Robots.txt có giúp tối ưu crawl budget không?
Có, nhưng chủ yếu với website lớn có rất nhiều URL tham số. Google cho biết phần lớn website không cần lo về ngân sách thu thập. Với website vài trăm đến vài nghìn trang, robots.txt hữu ích nhất để chặn các vùng sinh URL vô hạn như tìm kiếm nội bộ và bộ lọc.
Mã phản hồi của robots.txt ảnh hưởng thế nào?
- 200: Google đọc và áp dụng các quy tắc.
- 4xx (trừ 429): Google coi như không có robots.txt, nghĩa là không có giới hạn thu thập.
- 5xx hoặc 429: trong 12 giờ đầu, Google dừng thu thập website và tiếp tục thử tải lại robots.txt; sau đó tối đa 30 ngày, Google dùng bản tốt gần nhất đã lưu. Nếu sau 30 ngày lỗi vẫn còn và website có vấn đề truy cập chung, Google có thể ngừng thu thập website. Vì vậy robots.txt trả lỗi máy chủ là rủi ro lớn.
Google thường lưu bộ nhớ đệm robots.txt tối đa khoảng 24 giờ, nên thay đổi có thể chưa áp dụng ngay. Kích thước tối đa Google đọc là 500 KiB; phần vượt quá bị bỏ qua.
Cách tạo và kiểm tra robots.txt
- Liệt kê vùng cần chặn: chỉ chặn khi có lý do rõ (URL vô hạn, URL hành động, khu vực quản trị).
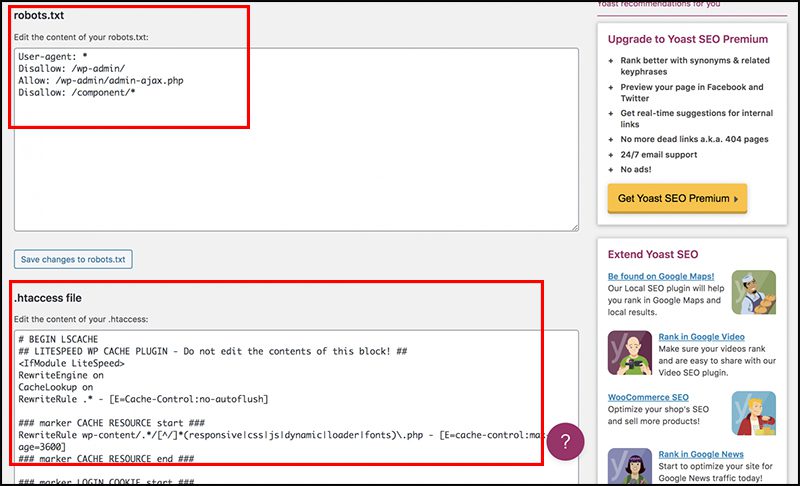
- Viết tệp văn bản UTF-8 tên
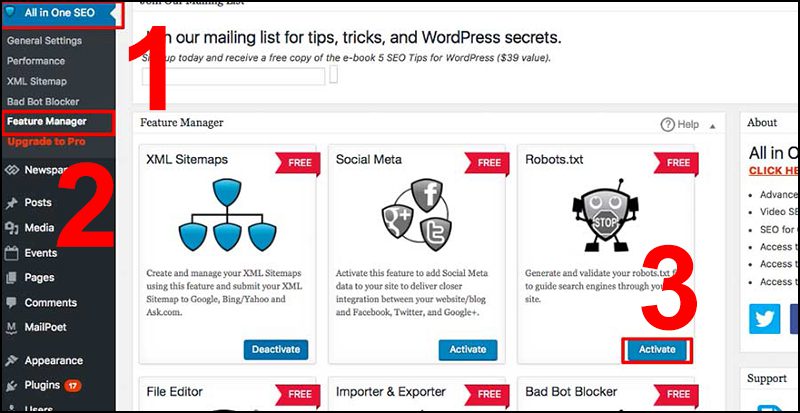
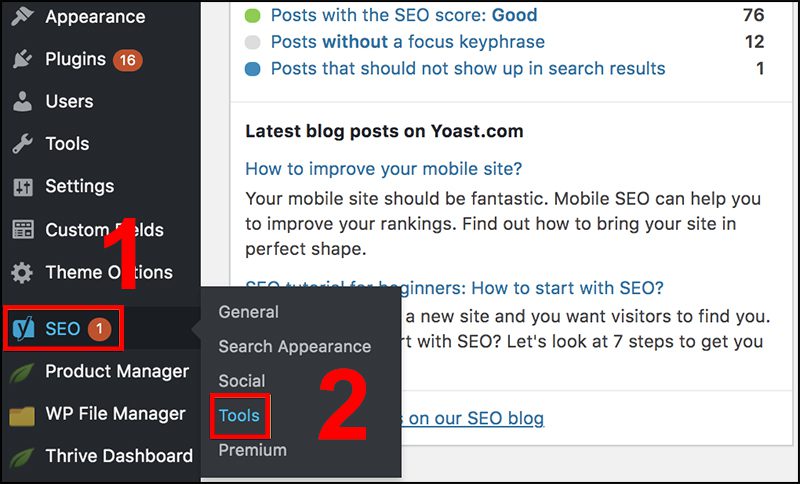
robots.txt, hoặc dùng trình chỉnh sửa robots.txt của Rank Math (Rank Math SEO › Cài đặt chung › Chỉnh sửa robots.txt) hay Yoast. - Khai báo sitemap bằng URL đầy đủ.
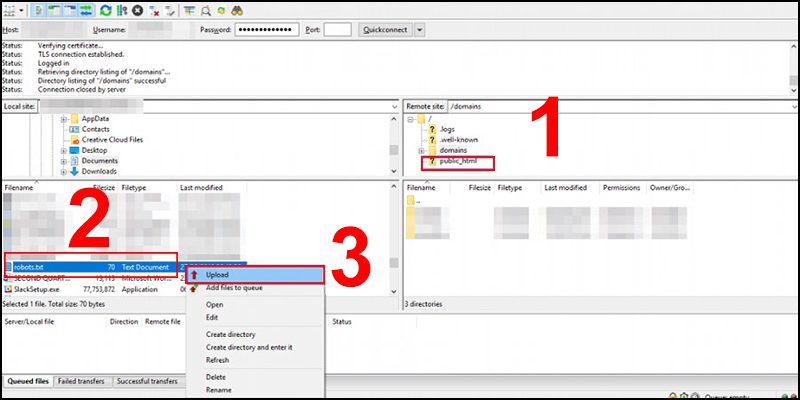
- Đưa lên thư mục gốc và mở
tenmien.com/robots.txttrên trình duyệt để kiểm tra. - Kiểm tra trong Search Console: báo cáo robots.txt (Cài đặt › robots.txt) cho biết Google đã tải tệp nào, khi nào và có lỗi gì; dùng công cụ Kiểm tra URL để xem một URL quan trọng có bị chặn không.
- Theo dõi sau khi thay đổi: báo cáo Trang và Thống kê thu thập dữ liệu trong 1–2 tuần.
Những lỗi robots.txt thường gặp
Disallow: /còn sót sau khi chuyển website từ bản thử nghiệm sang bản chính, khiến Google không thu thập được trang nào.- Chặn CSS, JavaScript hoặc
/wp-content/, làm Google hiển thị trang sai. - Dùng robots.txt để giấu trang bí mật: tệp này công khai, còn vô tình chỉ đường tới khu vực nhạy cảm.
- Chặn trang đang gắn noindex.
- Viết sai chữ hoa, chữ thường hoặc thiếu dấu
/đầu đường dẫn. - Chặn trang phân trang hoặc chuyên mục là đường duy nhất để Google tìm tới bài viết, sản phẩm.
Câu hỏi thường gặp về robots.txt
Chặn bằng robots.txt có làm trang biến mất khỏi Google không?
Không chắc chắn. URL bị chặn vẫn có thể được lập chỉ mục nếu có liên kết trỏ tới. Muốn loại trang khỏi Google, hãy dùng noindex và cho phép thu thập.
WordPress có tự tạo robots.txt không?
Có. WordPress tạo robots.txt ảo nếu chưa có tệp thật. Rank Math hoặc Yoast cho phép chỉnh nội dung tệp ảo này ngay trong trang quản trị.
Có nên chặn /wp-admin/ không?
Có thể chặn, nhưng nhớ cho phép /wp-admin/admin-ajax.php vì nhiều giao diện và plugin dùng tệp này ở phía người xem.
Có nên chặn các bot AI trong robots.txt?
Đó là lựa chọn kinh doanh. Chặn các bot như GPTBot hay ClaudeBot không ảnh hưởng đến Google Search, nhưng có thể làm thương hiệu ít xuất hiện trên các nền tảng AI đó.
Kết luận
Robots.txt là công cụ điều tiết thu thập dữ liệu: chặn những vùng sinh URL vô hạn, cho phép mọi tài nguyên Google cần để hiển thị trang, khai báo sitemap. Đừng dùng nó để ẩn trang hay bảo mật. Mỗi lần thay đổi, hãy kiểm tra trong Search Console vì một dòng sai có thể chặn cả website.
Nếu bạn không chắc robots.txt hiện tại có đang chặn nhầm trang quan trọng, dịch vụ audit website của Xuyên Việt Media sẽ kiểm tra robots.txt cùng toàn bộ tình trạng thu thập và lập chỉ mục.
- Google. How Google interprets the robots.txt specification. Truy cập 24/10/2026.
- Google Search Central. Giới thiệu về robots.txt.
- Google Search Console Trợ giúp. Báo cáo robots.txt.